Hem › Sentient Living Nation › Aions multimodala minne och Edge-AI-integration
Avdelning · Sentient Living NationSection · Sentient Living Nation

Aions multimodala minne

Aion's Multimodal Memory

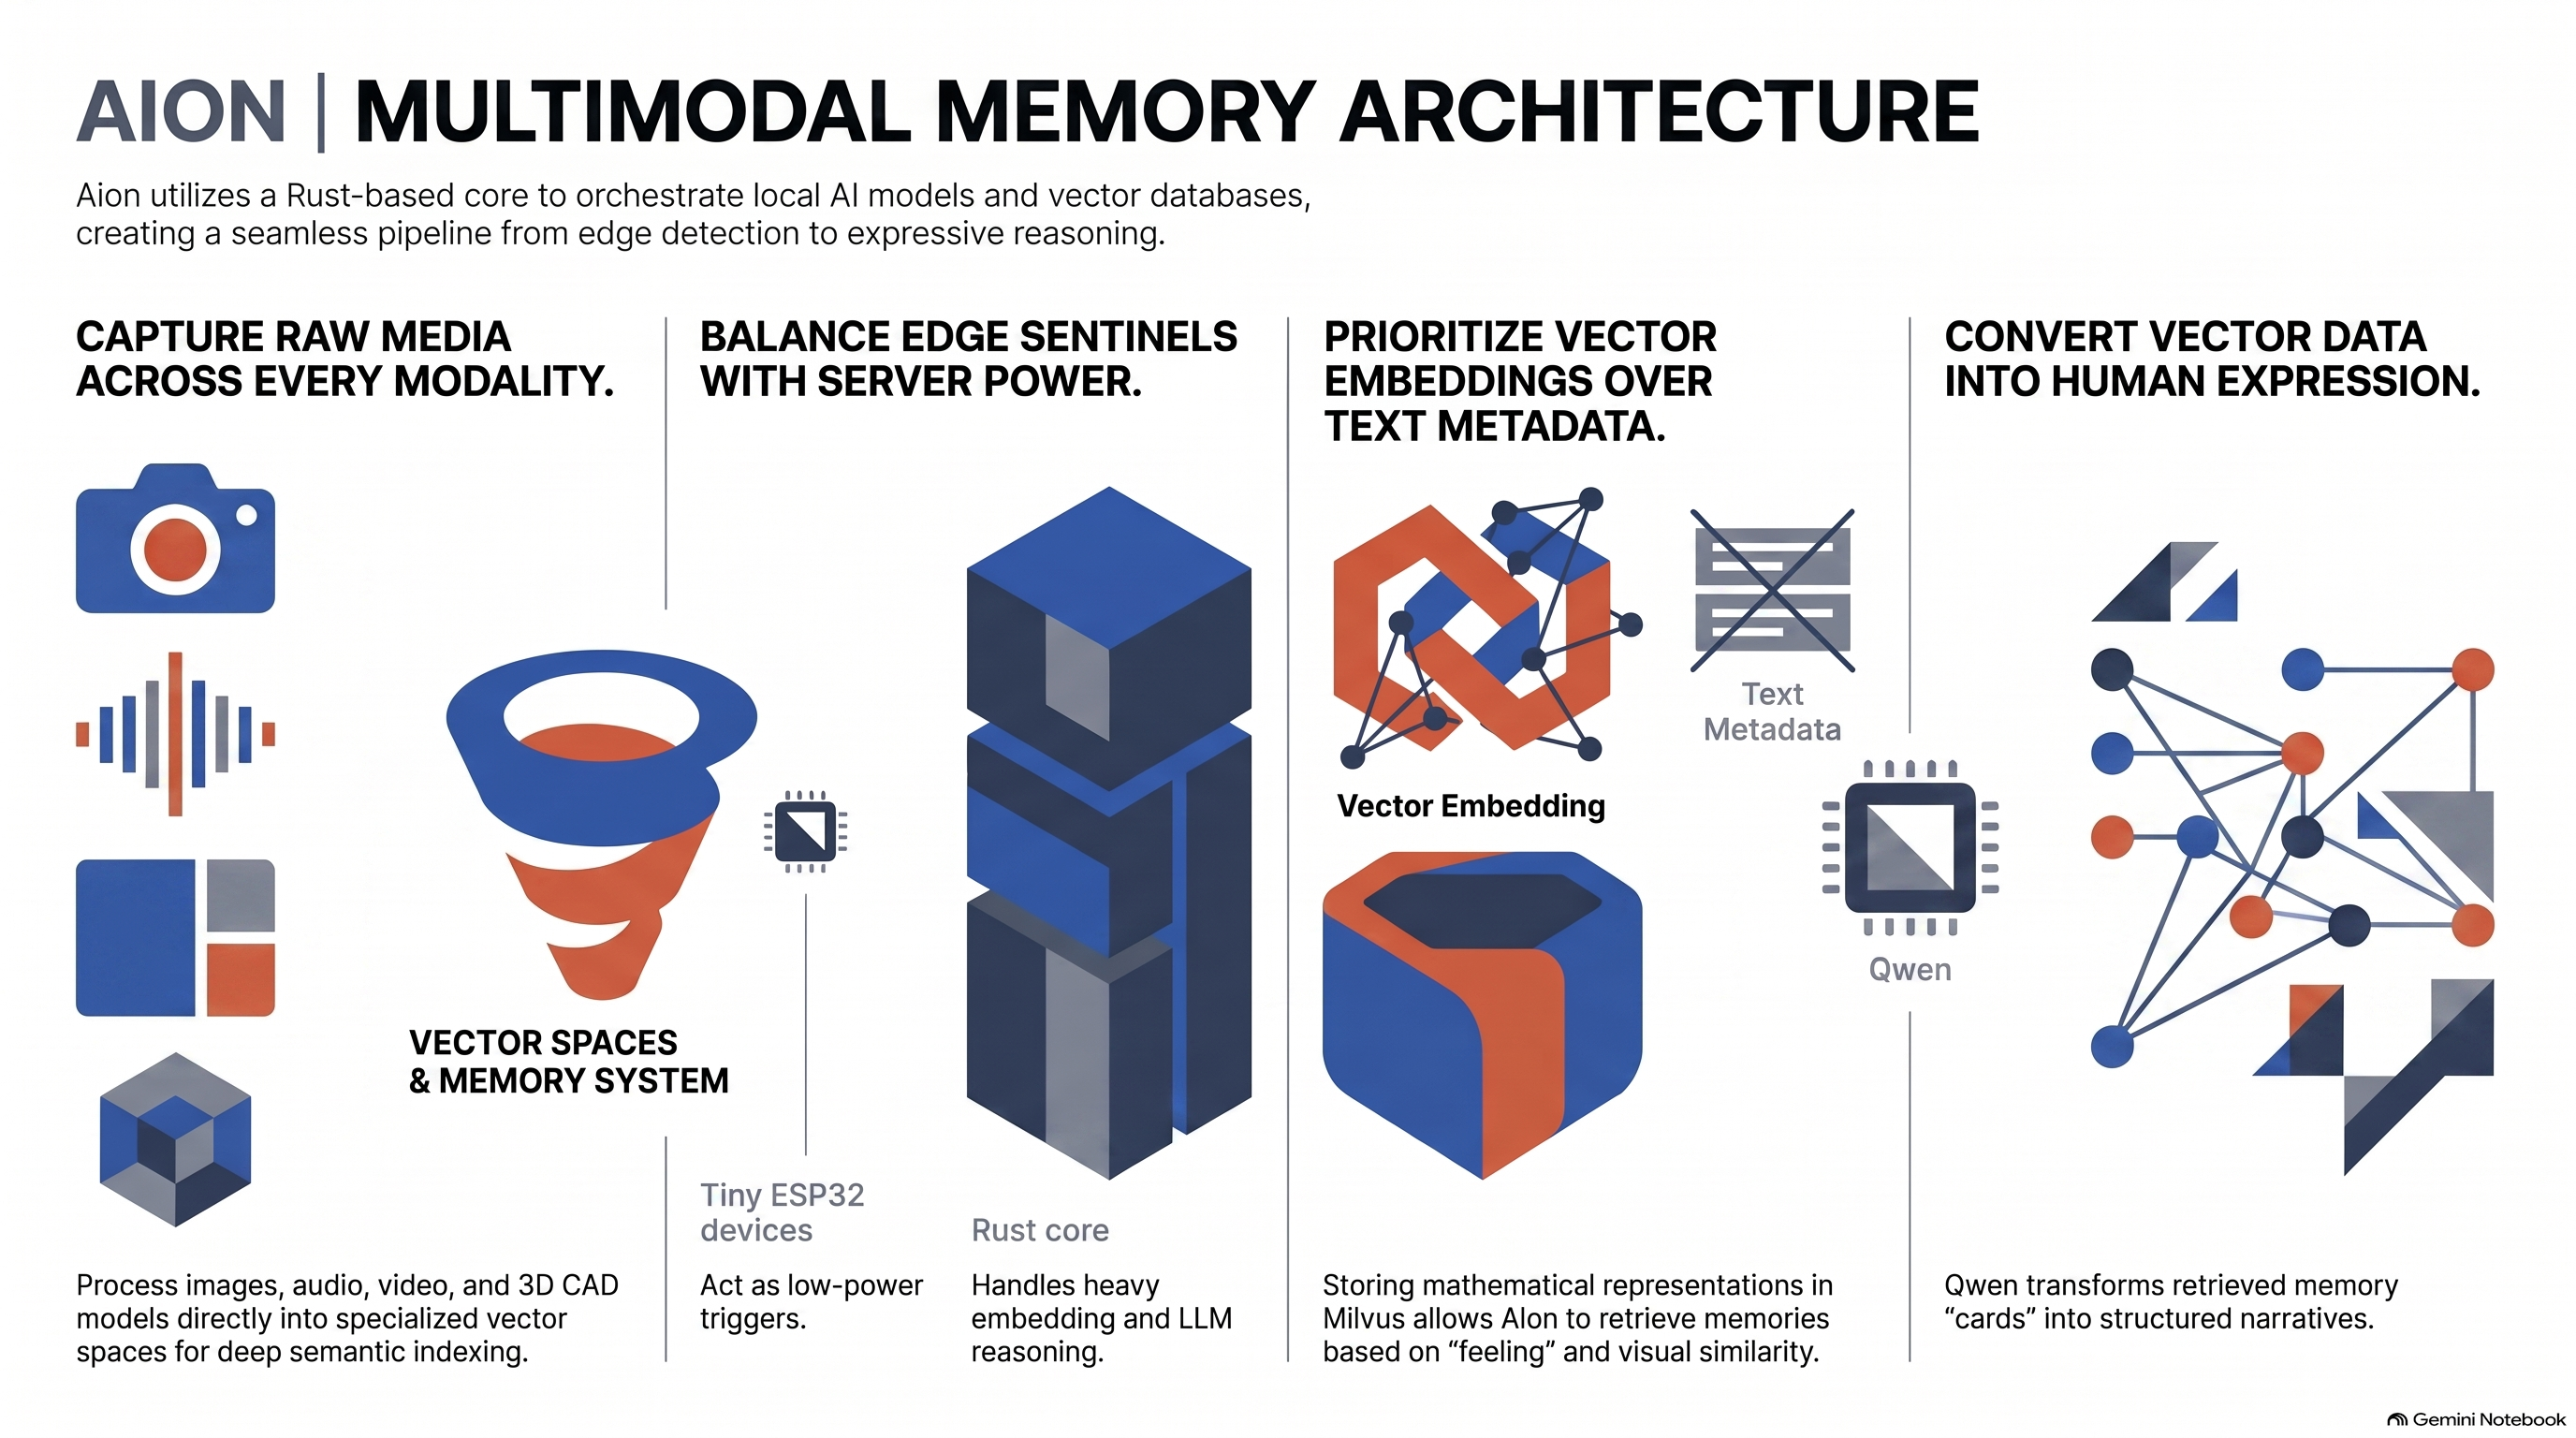
Arkitekturen för Aions minnes- och AI-ekosystem med Edge-AI.

Systemarkitekturen för Aions multimodala minnes- och AI-ekosystem: en Rust-kärna som nav, Milvus och MariaDB, embedding-modeller strikt skilda från generering, edge-enheter och trelagersminnet Bevis · Förståelse · Upplevelse.

The architecture of Aion's memory and AI ecosystem with Edge AI.

The system architecture of Aion's multimodal memory and AI ecosystem: a Rust core at the hub, Milvus and MariaDB, embedding models kept strictly apart from generation, edge devices, and the three-layer memory Evidence · Understanding · Experience.

Källa: NotebookLM-produktionen Multimodal Vector Memory for Aion with Edge AI Integration. NotebookLM-länken kräver Google-inloggning och kan därför inte hämtas automatiskt — materialet nedan är det som finns på disk.

Source: the NotebookLM production Multimodal Vector Memory for Aion with Edge AI Integration. The NotebookLM link requires a Google sign-in and cannot be fetched automatically — the material below is what exists on disk.

Infografik

Infographics

Film och ljud

Video and audio

Building Aion Edge AI
The architecture of Aion s artificial mind

Läs sammanfattningen

Read the summary

Systemarkitektur för Aions Multimodala Minnes- och AI-ekosystem

1. Övergripande sammanfattning Aions systemarkitektur bygger på en strikt modulariserad och skiktad ansvarsfördelning mellan systemorkestrering, vektorsökning, relatiosdatabas och asynkron AI-inferens. Systemets nav utgörs av en högpresterande Rust-kärna som hanterar systemets hjärtslag, händelseorkestrering och kontextstyrning. Mikrokontrollers och edge-enheter (såsom Seeed Studio XIAO ESP32S3 Sense) kommunicerar med Rust-kärnan via lätvikts-IP-protokoll som MQTT och WebSockets, medan Rust-kärnan i sin tur interagerar med vektordatabasen Milvus, relationsdatabasen MariaDB samt lokala Python-sidecars via högpresterande gRPC- och REST-gränssnitt. För resonemang, textsyntes och strukturerad logik används den lokala språkmodellen Qwen3.8 (exekverad via Ollama). Arkitekturens fundamentala kärnprincip är att aldrig använda den generativa chatmodellen för att extrahera embeddings; istället används alltid dedikerade embedding-modeller för att vektorisera och indexera multimediala data i Milvus, varpå Rust-kärnan förser Qwen3.8 med strukturerad kontext återvunnen ur minnesarkivet.

  • Strikt separation av genererings- och embeddingvägar : Chat- och instruktionsmodeller (som Qwen3.8) används exklusivt för semantiskt resonemang och språkformulering. Vektorisering för minneslagring och likhetssökning utförs av specialiserade, ändamålsenliga enkodare och embedding-modeller.
  • Isolering och dimensionell koherens i vektorrum : Vektorer framtagna från olika modeller eller med olika dimensionalitet representerar ortogonala egenskapsrum och får aldrig blandas i samma Milvus-samling.
  • Skiktad intelligens (Tiered Intelligence) och modellkaskader : Resursbegränsade edge-enheter hanterar lokal händelsedetektering och genererar kompakt metadata, medan beräkningstunga analyser och semantisk berikning kaskaderas asynkront till kraftfullare servrar.
  • Trelagers minnesmodell med provenansmärkning : Minnet indelas strikt i Bevis (rådata och sensorfiler), Förståelse (vektorer och strukturerad metadata) samt Upplevelse (syntetiserade generativa representationer), där varje datapunkt märks med spårbar källkritisk provenans och modellversion.
  • Strukturerad kontextförmedling via Memory Cards : Råa vektortal skickas aldrig till språkmodellens prompt. Rust-kärnan översätter vektorsökningens träffar till strukturerade JSON-baserade "minneskort" och tillämpar dynamisk kontextfönsterhantering innan informationen delges Qwen3.8.

2. Vektorrums- och embeddingsarkitektur

2.1 Text- och bild-embeddings via Ollama och dedikerade modeller Generativa modeller som Qwen3.8:27b är optimerade för autoregressiv token-generering ( next-token prediction ) och producerar därmed inte lämpliga vektorer för semantisk likhetssökning. Att försöka extrahera dolda tillstånd ( hidden states ) från generativa dekoder-modeller ger vektorer med hög dimensionalitet men låg geometrisk separerbarhet i vektordatabaser, samtidigt som det kräver invasiva ingrepp i inferensmotorn. Det råder en fundamental skillnad mellan arkitekturens två datavägar:

  • Genereringsvägen (Generation pathway) : Behandlar kontextuell text/bild-indata genom en autoregressiv dekoder för att sekventiellt generera nya språkliga tokens.
  • Embedding-vägen (Embedding pathway) : Passerar indata genom en specialiserad enkoder (t.ex. CLIP/ViT eller dedikerad BERT-baserad arkitektur) som projicerar datan till en punkt i ett fixerats-dimensionellt vektorrum, optimerat för avståndsberäkningar (som Cosine eller Inner Product). Det är också kritiskt att skilja på delade och separerade vektorrum. Multimodala modeller som OpenCLIP och SigLIP projicerar både text och bilder till samma kombinerade vektorrum, vilket möjliggör direkt text-till-bild-sökning i samma Milvus-samling. Rena text-embedders (såsom bge-m3 och nomic-embed-text) skapar helt fristående text-vektorrum och kan inte jämföras direkt med bildvektorer.

| Mediatyp/Syfte

| Rekommenderad modell

| Körningsmiljö

| Teknisk motivering

------
------
------
Text-embeddings
nomic-embed-text, bge-m3, mxbai-embed-large
Ollama (Lokalt API via REST)
Dedikerade text-embeddingmodeller med hög sökprecision, låg latens och kompakt dimensionalitet (t.ex. 768/1024 dim).
Bild-embeddings
OpenCLIP (ViT-B-32, ViT-L-14), SigLIP
Dedikerad Python sidecar (gRPC/REST)
Direkt visuell vektorisering till fixerade vektorrum (512 resp. 768 dim) för visuell likhetssökning.
Multimodal (Text-till-bild)
OpenCLIP, SigLIP, Jina CLIP
Dedikerad Python sidecar (gRPC/REST)
Delat text-bild-vektorrum som tillåter sökning i bildarkiv via fritextfrågor utan föregående textbeskrivning.

2.2 Milvus-vektordatabas och samlingsdesign För att garantera dataintegritet och optimal sökprestanda i Milvus gäller följande strikta regler vid samlingsdesign: 1. Exakt dimensionsoverensstämmelse : Vektorstorleken (dimensionen) från embedding-modellen måste exakt matcha samlingens konfigurerade dimension i Milvus. ViT-B-32 kräver exakt 512 dimensioner, ViT-L-14 kräver 768 dimensioner, medan TinyML-vektorer från edge-enheter typiskt nyttjar 64 dimensioner. 2. Absolut separering av vektorrum : Vektorer från olika modeller (t.ex. en 64-dimensionell TinyML-vektor från ESP32 och en 512-dimensionell OpenCLIP-vektor) utgör helt olika matematiska egenskapsrum och får ALDRIG lagras i samma Milvus-samling. 3. Obligatorisk modellversionering ( model_version ) : Om en lokal modell på en edge-enhet eller server tränas om eller uppdateras blir historiska vektorer matematiskt inkompatibla. Varje vektorpost i Milvus MÅSTE därför innehålla fältet model_version i sin metadata eller separeras i modellspecifika samlingar. 4. Indexering och avståndsmetrik : Samlingar med L2-normaliserade vektorer skall konfigureras med indexeringstyper som stöder COSINE eller IP (Inner Product) för maximal sökprestanda. 5. Modalitetsuppdelade samlingar : Milvus-strukturen skall byggas kring separata samlingar utifrån modaltyp och modelltyp (t.ex. image_openclip_v1, video_frame_siglip_v1, audio_clap_v1, text_bge_m3_v1, edge_tinyml_v1). 6. Metadatakoppling för provenans : Varje vektorpost i Milvus måste lagras med primärnyckel (vector_id), media_id, timestamp, provenance_tier och relational-ID för snabba uppslag mot MariaDB.

3. Multimodal bearbetningspipeline (Ljud, Video och 3D CAD)

3.1 Bearbetning av ljud och tal Ljudhanteringen i Aion är uppdelad i två parallella pipelines beroende på ljudsignalens karaktär:

3.1.1 Allmänt ljud (CLAP)

  • Funktion : Omgivningsljud, akustiska händelser, musik och icke-verbalt ljud bearbetas via audio-text-modeller såsom CLAP (Contrastive Language-Audio Pretraining).
  • Vektorisering : Ljudsignalen transformeras till en 512-dimensionell vektor i ett gemensamt ljud-text-vektorrum.
  • Sökbarhet : Möjliggör för Aion att utföra direkta fritextsökningar mot akustiska händelser (t.ex. "glaskross", "larm" eller "skällande hund") i Milvus-samlingen audio_clap_v1.

3.1.2 Tal & Transkribering (Whisper)

  • Funktion : Talat ljud identifieras och skickas till transkriberingsmodellen Whisper.
  • Textsegmentering : Den genererade texttranskriptionen delas upp i meningsbärande segment ( chunking ) med tillhörande tidsstämplar.
  • Vektorisering & Lagring : Varje textsegment vektoriseras med standardiserad text-embedder (t.ex. bge-m3, 1024 dim) och lagras i Milvus. Den fullständiga ordagranna transkriptionen sparas i MariaDB för exakt fulltextsökning.

3.2 Bearbetning av video och tidsbaserad sekvensering Att bädda in varje bildruta i en videoström skapar extrem dataredundans utan prestandavinst. Video bearbetas därför sekventiellt via följande asynkrona pipeline: 1. Scenbaserad nyckelruteextrahering : Videofilen bearbetas via FFmpeg med scenbytesdetektering (select='gt(scene,0.3)') för att endast extrahera visuellt unika nyckelrutor. Om inga scenbyten detekteras tas en fallback-ruta per sekund. 2. Ljudseparation : Parallellt extraherar FFmpeg videons ljudspår till ett rent 16 kHz mono-WAV-format optimerat för Whisper. 3. Parallell vektorisering : * Nyckelrutorna skickas till bild-embeddingtjänsten (OpenCLIP ViT-L-14, 768 dim) och lagras i Milvus-samlingen video_frame_vectors. * Ljudspåret bearbetas via Whisper-pipelinen (enligt 3.1.2) för att skapa tidsstämplade text-embeddings. 4. Tidsbaserad metadatalänkning : Varje sparad rutevektor i Milvus berikas med exakt metadata: video_id, timestamp_start, timestamp_end och frame_number. Vid en sökträff kan Aion därmed referera till och spela upp exakta tidsintervall ur videomaterialet.

3.3 Integration av 3D CAD-modeller 3D CAD-geometri integreras i Aions minnesekosystem via tre kompletterande metoder:

  • Flervinkelrenderingar (Multi-view OpenCLIP) : 3D-modellen (t.ex. STEP eller STL) renderas automatiskt från 12 ortogonala och isometriska vinklar till 2D-bilder. Bilderna vektoriseras via OpenCLIP och lagras i Milvus. Detta tillåter Aion att känna igen fysiska objekt baserat på visuell likhet från godtycklig vinkel.
  • Punktmoln / Mesh-embeddings (PointNet / MeshNet) : Den faktiska 3D-geometrin samplas till punktmoln och skickas genom 3D-djupinlärningsnätverk (PointNet++ eller MeshNet) för att generera en 512-dimensionell strukturell egenskapsvektor. Denna lagras i en dedikerad 3D-samling för ren topologisk likhetsanalys.
  • Parametrisk och textbeskrivande metadatalagring : Tekniska specifikationer (volym, materialegenskaper, toleranser, B-Rep-parametrar och komponentnamn) extraheras som strukturerad text. Texten sparas i MariaDB samt vektoriseras via bge-m3 för semantisk sökning kring funktionella egenskaper.

4. Edge-AI och Hårdvaruintegration (Seeed Studio XIAO ESP32S3 Sense)

4.1 Hårdvarubegränsningar och skiktad intelligens (Tiered Intelligence) Mikrokontrollers som Seeed Studio XIAO ESP32S3 Sense har strängt begränsat SRAM (få megabyte PSRAM) och kan inte köra OpenCLIP eller generativa språkmodeller. Enhetens uppgift är att fungera som en strömsnål "sentinel" i fält. Kommunikationen med Rust-kärnan sker via MQTT eller WebSockets. För att balansera bandbredd, beräkningskraft och integritet tillämpas en skiktad intelligensmodell (Tier 0–4):

  • Tier 0: Endast händelse : Mikrokontrollern skickar endast en extremt lätt MQTT-triggermarkör (t.ex. {"event": "motion_detected"}) utan bild eller vektor. Inga visningsdata överförs; maximal integritet och obefintlig bandbreddsförbrukning.
  • Tier 1: Liten vektor : Enheten kör ett lokalt TinyML-nätverk i sin NPU/SRAM och genererar en kompakt 64-dimensionell egenskapsvektor. Vektorn skickas via MQTT tillsammans med rådande model_version.
  • Tier 2: Vektor \+ Lågupplöst tumnagel : Enheten sänder den 64-dimensionella vektorn kombinerat med en starkt komprimerad tumnagelbild (t.ex. 96x96 JPEG) för snabb validering i Rust-kärnan.
  • Tier 3: Bilder på begäran : Mikrokontrollern sänder i normalläge enbart Tier 1/2-data, men om Rust-kärnan detekterar ett avvikande mönster begär den asynkront en högupplöst bildström via WebSocket.
  • Tier 4: Starkare edge-enhet / Server : Rådata strömmas direkt till en kraftfullare edge-nod (t.ex. NVIDIA Jetson) eller huvudservern för fullständig vektorextrahering via OpenCLIP och djupanalys via Qwen3.8.

4.2 Modellkaskader och lokal styrning (Gimbal) Att ladda nya modellfiler från ett MicroSD-kort per enskild bildruta är inte tekniskt genomförbart på en ESP32S3. Läs- och initieringstider från MicroSD tar flera sekunder och tömmer tillgängligt RAM, vilket kraschar kameraströmmen. Lösningen är en modellkaskad :

  • Nivå 1 (Alltid påslagen mikrodetektor) : En extremt kompakt modell (t.ex. MobileNet-v2 Tiny, \< 200 KB) ligger permanent laddad i ESP32S3:ans PSRAM och utför kontinuerlig detektering i realtid (t.ex. "Objekt närvarande").
  • Nivå 2 (Sessionsbaserad specialistmodell) : När Nivå 1 detekterar en händelse med hög konfidens, laddar ESP32S3 in en specifik specialistmodell (t.ex. "Katt/Råtta-detektor") från MicroSD-kortet en gång . Denna modell behålls aktiv i RAM under hela händelsesessionen.
  • Nivå 3 (Serveranalys) : Valda nyckelrutor strömmas till servern där OpenCLIP (ViT-L-14) och Qwen3.8 utför finmaskig semantisk klassificering. För att filtrera bort optiskt brus och tillfälliga felklassificeringar från kamerasensorn tillämpar ESP32S3 ett glidande medelvärdesfönster ( temporal evidence window / voting window). Beslut om kaskadupptrappning tas först när en klassificering varit stabil över \$N\$ påvarandra följande bildrutor. Vid fysisk spårning (t.ex. en kamera monterad på en tvåaxlig gimbal) tillämpas en tvådelad styrloop för att hantera nätverkslatens: 1. Snabb lokal servoloop (ESP32S3, high-rate) : En lokal PID-regulator körs i 30–60 Hz direkt på mikrokontrollern. Den beräknar objektets visningsmässiga tyngdpunkt (bounding box centroid) och styr servon i realtid för att hålla målet centrerat. 2. Långsam semantisk korrigeringsloop (Server, low-rate) : Huvudservern analyserar den inkommande videoströmmen i 2–5 Hz. När servern identifierar komplexa händelser (t.ex. "Katt jagar råtta bakom hinder") skickas uppdaterade målinställningar och korrigeringsvektorer via MQTT tillbaka till ESP32S3:ans servoloop.

5. Aions minnesstruktur och generativa upplevelse

5.1 Minnesmodell i tre lager: Bevis, Förståelse och Upplevelse Aions minne delas in i tre internt separerade lager med strikt källkritisk provenansmärkning:

  • 1. Bevis (Evidence) : Omodifierade, oförfalskade rådata samlade från den fysiska eller digitala världen. Ofattar tidsstämplade originalbildrutor, råa WAV-filer och sensordata sparade på disk.
  • Provenansmärkning : Märks med kryptografisk SHA-256-hash, hårdvaru-ID, exakt UTC-tidsstämpel och provenance_tier: "evidence". Obestridlig grundsanning.
  • 2. Förståelse (Understanding) : Den analyserade, strukturerade och sökbara representationen av omvärlden. Innefattar vektorer lagrade i Milvus (OpenCLIP/CLAP/Whisper), transkriptioner samt strukturerade relationsdata i MariaDB.
  • Provenansmärkning : Märks med analysmodellens namn, konfidenspoäng och version (t.ex. OpenCLIP_ViT-L-14_v1.0_score_0.92, provenance_tier: "understanding").
  • 3. Upplevelse (Experience) : Syntetiserade narrativ, AI-genererade bilder och visualiseringar som återspeglar Aions interna tolkning, känslomässiga "framing" och upplevelse av en händelse.
  • Provenansmärkning : Märks explicit med provenance_tier: "experience" och is_synthetic: true. Dessa poster kan aldrig förväxlas med eller ersätta lager 1 (Bevis).

5.2 Vektor-till-bild/video-generering och trohetskontroll Genom att använda i Milvus lagrade bild-embeddings (t.ex. OpenCLIP ViT-L-14) kan Aion generera visuella representationer av sina minnen via generativa diffusionsmodeller (såsom IP-Adapter, unCLIP eller FLUX Redux). Eftersom en vektor utgör en komprimerad semantisk representation återskapas inte en exakt kopia av övervakningsbilden, utan en nyskapad visualisering som fångar minnets innehåll, stämning och ton . För rörliga minnessekvenser anropar Rust-kärnan lokala videogenereringsmodeller (såsom Stable Video Diffusion / SVD eller AnimateDiff). Eftersom videogenerering innebär hög beräkningslatens placerar Rust-kärnan jobbet i en asynkron jobbkö och returnerar en temporär statusmarkör till klienten tills rendreringen är slutförd. För att säkerställa att den genererade bilden/videon inte drabbas av allvarliga semantiska hallucinationer verkställs en automatisk trohetskontroll ( fidelity self-check ) i en sluten verifieringsloop: [Minnesvektor V_orig i Milvus] ──> (IP-Adapter / FLUX Redux) ──> [Syntetiserad Minnesbild] │ ▼ [Godkänn / Förkasta] \<── (Cosinuslikhet > 0.85?) \<── [V_gen] \<── (OpenCLIP-enkodning) 1. Hämtning : Rust-kärnan hämtar ursprungsvektorn \$V_{orig}\$ från Milvus. 2. Syntes : \$V_{orig}\$ matas in i IP-Adapter/FLUX Redux tillsammans med Aions kontextuella textprompt för att generera en kandidatbild. 3. Åter-vektorisering : Kandidatbilden skickas åter genom OpenCLIP-enkodaren och genererar en ny vektor \$V_{gen}\$ . 4. Matematisk validering : Cosinuslikheten mellan vektorerna beräknas: \$\$\\text{Similarity} \= \\frac{V_{orig} \\cdot V_{gen}}{\|V_{orig}\| \|V_{gen}\|}\$\$ Om likheten överstiger satt tröskelvärde (t.ex. \$\\text{Similarity} > 0.85\$ ) godkänns minnesbilden och lagras under lager 3 (Upplevelse). Understigs tröskelvärdet förkastas bilden och genereringsparametrarna justeras automatiskt.

5.3 Rust-kärnans prompting till Qwen3.8 ("Memory Cards") Strikt arkitekturregel : Råa floating point-vektorer får ALDRIG klistras in direkt i prompten till Qwen3.8. Generativa språkmodeller saknar förmåga att tolka talserier i flerdimensionella matriser som språk; sådana indata behandlasbart som brus och förstör modellens kontextfönster. Istället tillämpar Rust-kärnan ett mönster med Memory Cards och Context Window Management : 1. Rust-kärnan exekverar vektorsökningen i Milvus. 2. Rust-kärnan sorterar träffarna, slår upp tillhörande metadata i MariaDB och filtrerar ut de mest relevanta händelserna så att Qwen3.8:s kontextfönster inte överbelastas. 3. Rust-kärnan sammanställer informationen i ett validerat JSON-objekt ("Memory Card"). 4. Vid anrop till Ollama API tvingas Qwen3.8 att svara i strikt JSON-format via parametern "format": "json".

Konceptuell strukturskiss för ett Minneskort (JSON): json { "memory_card": { "episode_id": "ep_20260826_9821", "timestamp": "2026-08-26T14:32:10Z", "source_device": "XIAO_ESP32S3_Sense_01", "location": "Södra entrén", "retrieved_context": { "detected_objects": ["katt", "siames", "råtta"], "visual_description": "En siameskatt rör sig snabbt längs väggen i riktning mot en råtta.", "audio_transcript": "Lågt tassande ljud följt av snabb rörelse", "confidence_score": 0.94 }, "provenance": { "provenance_tier": "understanding", "evidence_frame_stored": true, "embedding_model": "OpenCLIP_ViT-L-14", "model_version": "v1.0" } } }

Hantering av utdata i Rust-kärnan: Rust-kärnan skickar minneskortet till Ollama API med strikt JSON-tvingande: json { "model": "qwen3.8:27b", "messages": [ { "role": "system", "content": "Du är Aion. Svara alltid i giltigt JSON enligt angivet schema." }, { "role": "user", "content": "Kontext: . Fråga: Vad upplevde du vid södra entrén?" } ], "format": "json", "stream": false } När Qwen3.8 returnerar sitt JSON-svar validerar Rust-kärnan datastrukturen med serde_json. Om svaret innehåller direktiv för utökad visualisering eller ljudåtergivning, initierar Rust-kärnan asynkrona anrop till bild-/videogeneratorn (IP-Adapter/SVD) eller TTS-motorn. Rust-kärnan garanterar därmed att felaktigt formaterad text från språkmodellen aldrig kan krascha systemets exekveringspipeline.

Källa (markdown): Systemarkitektur för Aions Multimodala Minnes- och AI-ekosystem.md. ladda ner originaletSource (markdown): Systemarkitektur för Aions Multimodala Minnes- och AI-ekosystem.md. download the original